Gdy infrastruktura na skalę Cloudflare zawodzi, skutki nie są tylko natury technicznej — są natychmiastowe, widoczne i często kosztowne.
18 listopada 2025 roku, a następnie 20 lutego 2026 roku, Cloudflare doświadczyło poważnych zakłóceń w świadczeniu usług, które wpłynęły na strony internetowe, interfejsy API i platformy cyfrowe w wielu regionach. Dla wielu firm incydenty te oznaczały nie tylko przerwy w działaniu usług, ale także zakłócenia w przychodach, działalności operacyjnej i zaufaniu klientów.
To, co czyni te wydarzenia ważnymi, to nie tylko to, co się wydarzyło, ale także to, co ujawniają one na temat współczesnych systemów. Obecnie większość aplikacji w dużym stopniu opiera się na infrastrukturze firm trzecich. Awaria tej warstwy wpływa na wszystko, co na niej bazuje.
W tym przewodniku wyjaśnimy, co się wydarzyło, co spowodowało te incydenty, jaki miały one wpływ na firmy w rzeczywistych scenariuszach i jak można zaprojektować systemy, które pozostaną odporne nawet w przypadku awarii usługi Cloudflare.
Co wydarzyło się podczas awarii Cloudflare w latach 2025 i 2026?
Awaria Cloudflare w listopadzie 2025 roku została wywołana wewnętrznym problemem z konfiguracją w systemie zarządzania botami. Wygenerowany plik konfiguracyjny przekroczył oczekiwane limity i został wdrożony w całej sieci globalnej. Doprowadziło to do awarii systemów przetwarzania ruchu i spowodowało poważne zakłócenia.
Incydent z lutego 2026 roku miał inny charakter. Zamiast problemów z konfiguracją, dotyczył problemów z routingiem na poziomie sieci, które wpływały na łączność dla określonych użytkowników i konfiguracji. Choć nie miał tak globalnego zasięgu, jego wpływ na firmy, których dotyczył, był nadal znaczący.
Oba incydenty podkreślają istotną kwestię, że nawet uznani dostawcy infrastruktury mogą w pewnych okolicznościach stawić czoła nieoczekiwanym awariom.
Harmonogram awarii Cloudflare (szczegółowy)
Zrozumienie przebiegu tych incydentów pozwala dostrzec, jak szybko drobne problemy mogą się eskalować.
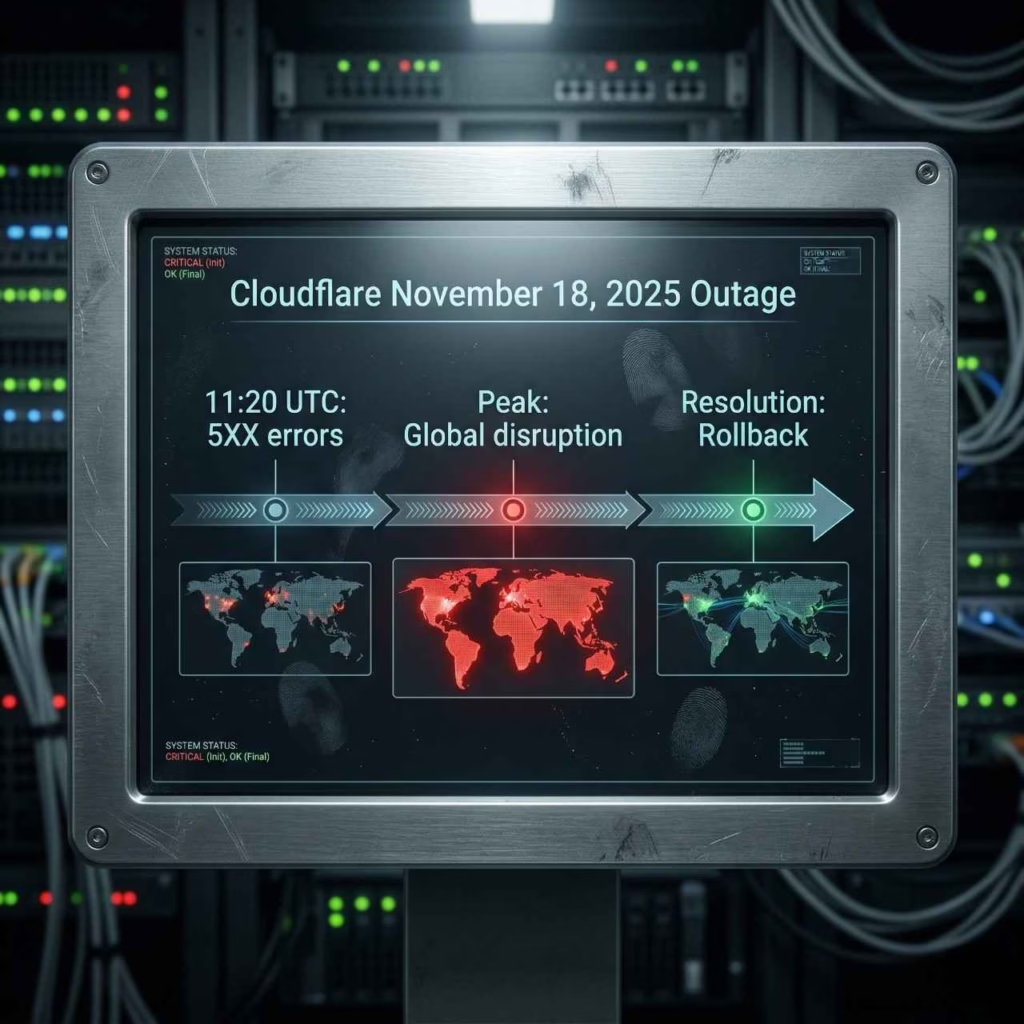
November 18, 2025
- 11: 20 UTC – Systemy zaczynają zgłaszać zwiększoną liczbę błędów 5xx
- Faza środkowa – Problem rozprzestrzenia się na wszystkie lokalizacje krańcowe na świecie
- Maksymalny wpływ – Witryny internetowe, interfejsy API i usługi ulegają awariom
- Rozkład – Zidentyfikowano błędną konfigurację i ją wycofano
To, co zaczęło się jako anomalia konfiguracji, szybko przerodziło się w globalne zaburzenie z powodu automatycznej propagacji.
20 lutego 2026 r.
- Początek incydentu – Niespójności w routingu zaczynają wpływać na ruch
- Faza środkowa – Problemy z łącznością nasilają się u niektórych użytkowników
- Maksymalny wpływ – Obserwowano spadek wydajności i częściowe przerwy w działaniu
- Rozkład – Poprawiono zachowanie sieci i przywrócono usługi
Incydent ten pokazał, że problemy na poziomie sieci mogą być równie uciążliwe jak awarie oprogramowania.
Co spowodowało awarię Cloudflare 18 listopada 2025 r.?
Własna analiza Cloudflare wskazała na wiele czynników mających wpływ na ten stan rzeczy.
Rozszerzenie pliku konfiguracyjnego
Dynamicznie wygenerowany plik konfiguracyjny przekroczył oczekiwane limity. Samo to nie byłoby krytyczne, ale spowodowało nieoczekiwane zachowanie systemów obsługujących ruch sieciowy.
Awaria potoku wdrażania
Błędna konfiguracja została wdrożona globalnie bez wystarczających kontroli poprawności. Wdrożenie etapowe lub bardziej rygorystyczna walidacja mogłyby rozwiązać problem na wczesnym etapie.
Ograniczenia obsługi błędów
Systemy nie radziły sobie z nieprawidłową konfiguracją. Zamiast bezpiecznie się zepsuć, po prostu zawodziły, potęgując skutki.
Brak zabezpieczeń propagacyjnych
Nie było żadnych mechanizmów mogących powstrzymać rozprzestrzenianie się wirusa, gdy zaczął on wpływać na systemy produkcyjne.
Połączenie tych czynników sprawiło, że problem, z którym można było sobie poradzić, przerodził się w zamieszanie na dużą skalę.
Co było przyczyną incydentu Cloudflare z 20 lutego 2026 r.?
Drugi incydent miał swoje źródło w zachowaniu sieci, a nie w konfiguracji.
- Niespójności w trasach zakłóciły przepływ ruchu
- Niektóre konfiguracje IP były dotknięte bardziej niż inne
- W systemach opartych na określonych konfiguracjach routingu zaobserwowano pogorszenie wydajności
W przeciwieństwie do wydarzenia z 2025 r., nie chodziło tu o wdrożenie, ale o sposób zarządzania ruchem w sieci.
Pomimo różnic, wynik był podobny: zmniejszona dostępność i negatywny wpływ na użytkowników.
Porównanie awarii Cloudflare: 2025 i 2026
| WYGLĄD | w listopadzie 2025 roku | luty 2026 |
| Przyczyna główna | Problem z konfiguracją | Problem z trasowaniem sieci |
| Zakres | Globalny | Częściowe, ale znaczące |
| Czas trwania: | Krótki, ale szeroko rozprzestrzeniony | Kilka godzin |
| Dotknięte systemy | CDN, API, sieć brzegowa | Łączność sieciowa |
| Kluczowa lekcja | Błąd walidacji | Odporność infrastruktury |
Wpływ przerw w działaniu Cloudflare na firmy
Gdy dochodzi do awarii Cloudflare, konsekwencje nie ograniczają się wyłącznie do zespołów technicznych.
Utrata przychodów
Platformy e-commerce i aplikacje SaaS mogą utracić transakcje w ciągu kilku minut. Nawet krótkotrwała przerwa w działaniu może znacząco wpłynąć na dzienne przychody.
Przerwa w działaniu witryny i aplikacji
Użytkownicy napotykają strony z błędami, powolne odpowiedzi lub całkowitą niedostępność. To prowadzi do natychmiastowej frustracji i rezygnacji z korzystania z witryny.
Zakłócenia operacyjne
Wewnętrzne narzędzia, pulpity nawigacyjne i interfejsy API stają się niedostępne, co wpływa na wydajność i przepływy pracy.
Uszkodzenie reputacji
Użytkownicy rzadko rozróżniają dostawcę usług od dostawcy infrastruktury. Po prostu widzą, że platforma nie działa.
Strata marketingowa
Aktywne kampanie nadal kierują ruch na niefunkcjonalne strony, co skutkuje marnotrawieniem środków na reklamę.
Dlaczego awarie Cloudflare mają znaczenie dla nowoczesnych systemów
Cloudflare to nie tylko narzędzie. To część Twojej architektury.
Obsługuje:
- kierowanie ruchem
- buforowanie
- warstwy bezpieczeństwa
- optymalizacja wydajności
Gdy ta warstwa zawiedzie, system wydaje się nie działać, nawet jeśli zaplecze działa prawidłowo.
Dlaczego komunikat „Cloudflare nie działa” może spowodować awarię całej aplikacji
Wiele aplikacji jest w pełni zależnych od zewnętrznej infrastruktury w celu realizacji kluczowych operacji.
Gdy ta warstwa zawiedzie:
- użytkownicy nie mogą dotrzeć do Twojej aplikacji
- Interfejsy API przestają odpowiadać
- systemy logowania i uwierzytelniania mogą zawieść
Z punktu widzenia użytkownika cały system jest wyłączony.
Dlatego ryzyko zależności jest jednym z największych wyzwań współczesnej architektury.
Jak sprawdzić status awarii Cloudflare
Pierwszym krokiem diagnozy problemu jest weryfikacja.
Można:
- sprawdź oficjalną stronę statusu
- korzystaj z niezależnych narzędzi monitorujących
- zweryfikuj za pomocą usług zapewniania dostępności stron trzecich
- analizuj logi i odpowiedzi na błędy
Korzystanie z wielu źródeł zapewnia lepszą przejrzystość podczas incydentów.
Czy Cloudflare jest dziś nieczynny?
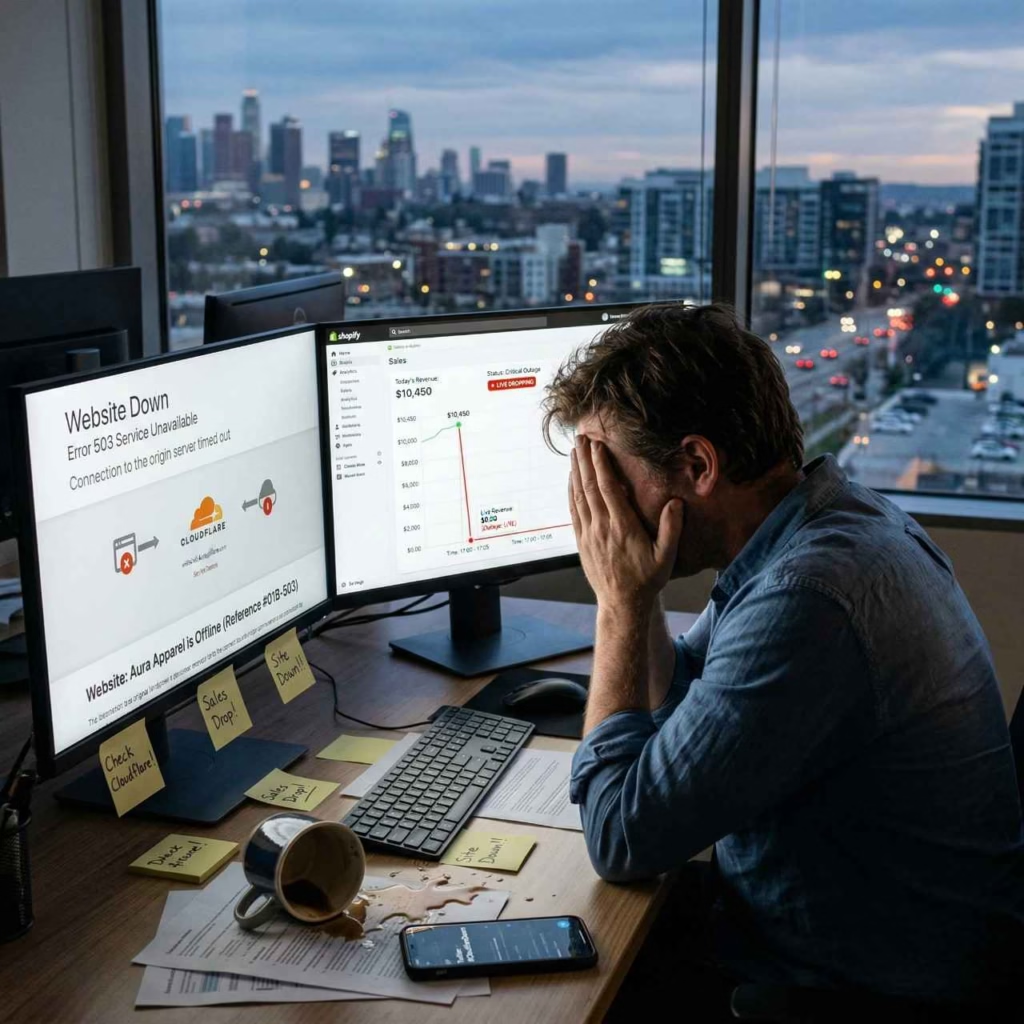
Przerwy w działaniu Cloudflare nie zdarzają się często, ale jednak się zdarzają.
Jeśli Twój system nie działa zgodnie z oczekiwaniami, sprawdzanie aktualizacji statusu w czasie rzeczywistym jest niezbędne . Pomaga to ustalić, czy problem ma charakter lokalny, czy jest częścią większej awarii.
Jak zmniejszyć ryzyko awarii usługi Cloudflare
Unikanie zależności nie jest praktyczne, wręcz przeciwnie.
Strategia Multi-CDN
Korzystanie z wielu dostawców zmniejsza zależność od pojedynczego punktu awarii.
Systemy zapasowe DNS
Pomocniczy serwer DNS zapewnia możliwość kierowania ruchem w przypadku zakłóceń.
Postępująca degradacja
Systemy powinny nadal działać w ograniczonym zakresie, a nie ulegać całkowitej awarii.
Niezależny monitoring
Monitorowanie powinno pozostać aktywne nawet w przypadku awarii podstawowej infrastruktury.
Architektura failover
Projektuj systemy, które w razie potrzeby potrafią ominąć zależności.
Lekcje z awarii Cloudflare dla zespołów programistycznych
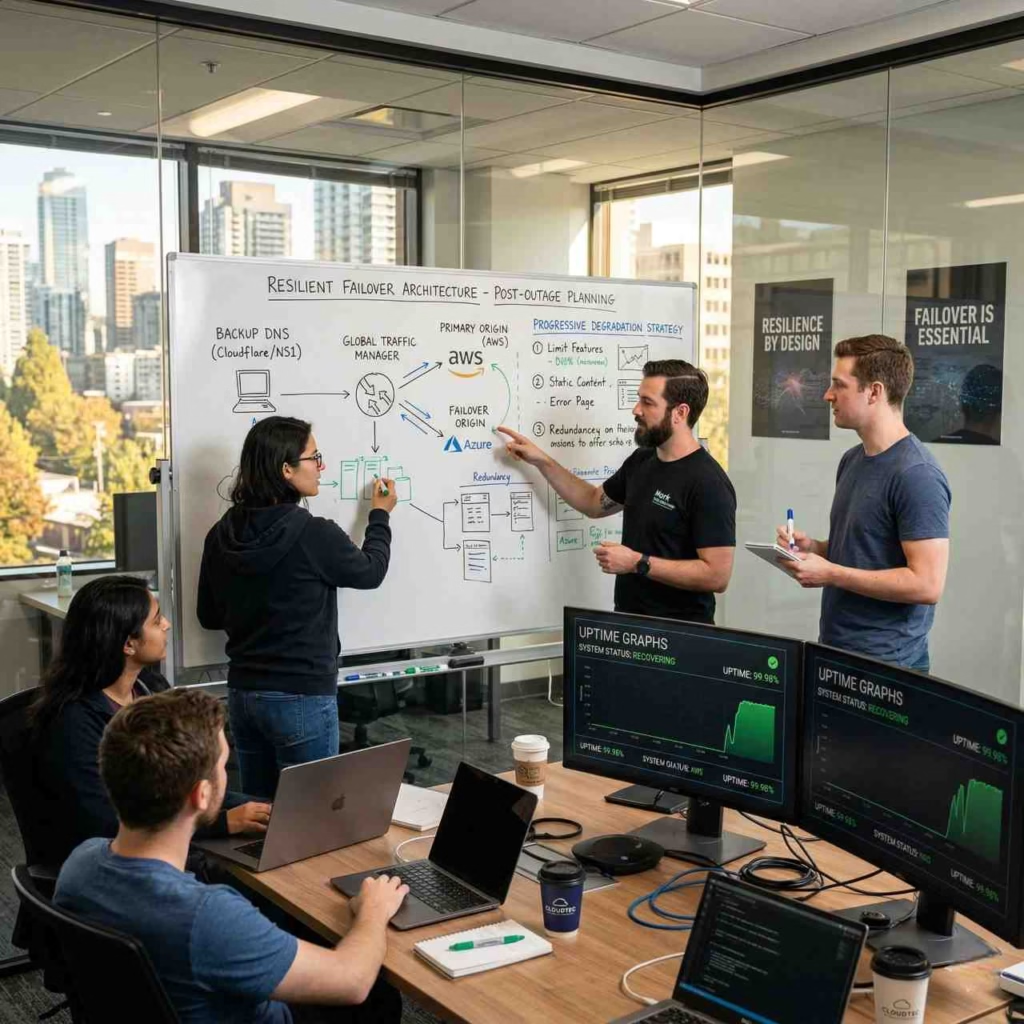
Incydenty te stanowią dla zespołów ważną lekcję.
Zbuduj na porażkę
Awarie są nieuniknione. Systemy muszą być zaprojektowane tak, aby sobie z nimi radzić.
Zmniejsz ryzyko zależności
Unikaj całkowitego polegania na jednym dostawcy.
Poprawa obserwowalności
Wgląd w działanie systemu ma kluczowe znaczenie podczas przerw w działaniu.
Skoncentruj się na doświadczeniu użytkownika
Nawet ograniczona funkcjonalność jest lepsza niż całkowity przestój.
Zaplanuj komunikację
Jasna komunikacja zmniejsza zamieszanie i utrzymuje zaufanie.
Branże najbardziej dotknięte awariami
Niektóre sektory są bardziej narażone:
- systemy opieki zdrowotnej
- platformy logistyczne i dostawcze
- aplikacje fintech
- systemy rezerwacji
W tych branżach przestoje mogą mieć poważne konsekwencje.
Przyszłość niezawodności infrastruktury
W miarę jak systemy będą coraz bardziej ze sobą powiązane, przerwy w dostawie prądu będą się zdarzać coraz częściej.
Należy przenieść nacisk z zapobiegania awariom na skuteczne zarządzanie nimi.
Organizacje inwestujące w odporność będą lepiej przygotowane na przyszłość.
Wniosek
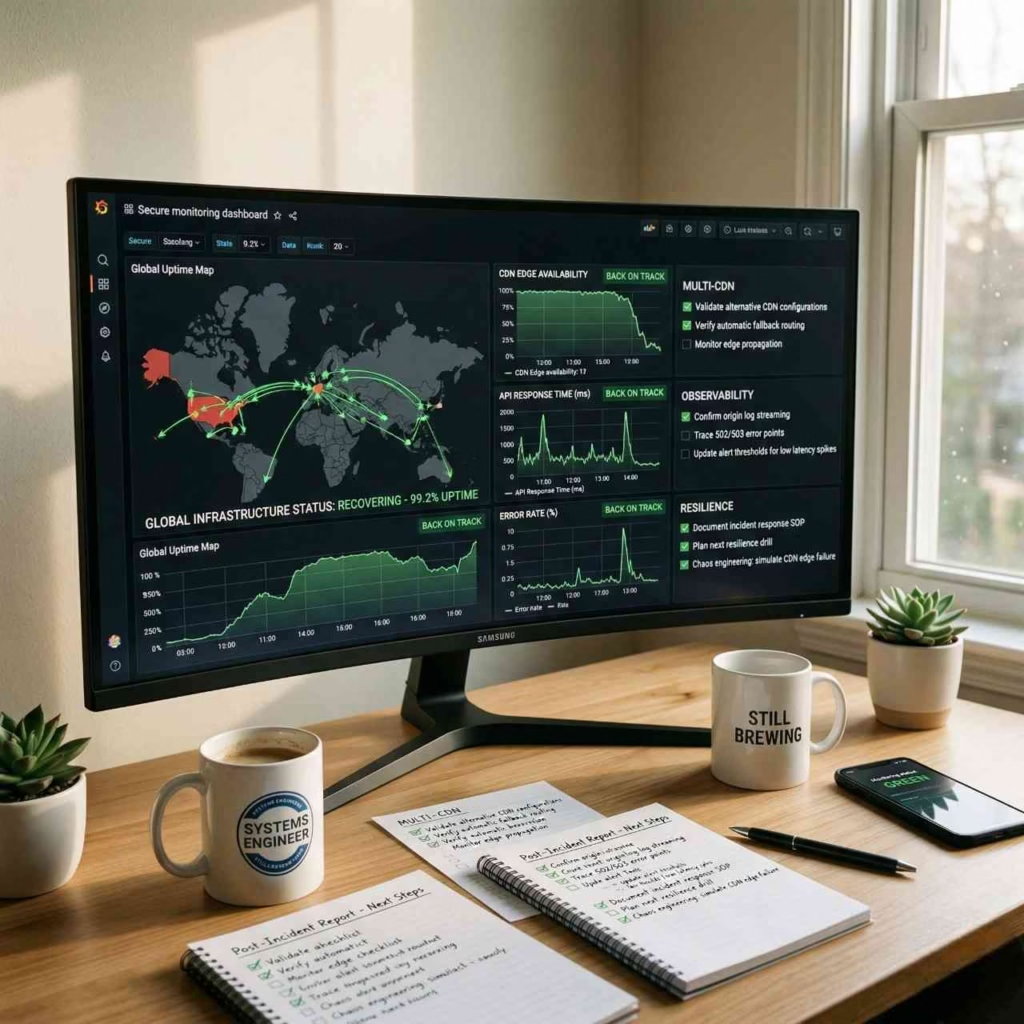
Awarie usługi Cloudflare, które miały miejsce 18 listopada 2025 r. i 20 lutego 2026 r., przypominają, że żadna infrastruktura nie jest całkowicie odporna na awarie.
Incydenty te pokazują, jak bardzo współczesne systemy są ze sobą powiązane i jak szybko mogą rozprzestrzeniać się zakłócenia.
Dla przedsiębiorstw wnioski są jasne:
- zmniejszyć zależność od jednego dostawcy
- projektowanie systemów zapewniających odporność
- przygotuj się na nieoczekiwane zakłócenia
Cloudflare to nadal potężna platforma, ale jej długoterminowa niezawodność zależy od tego, jak dobrze ją zbudujesz.
PYTANIA I ODPOWIEDZI
Co spowodowało awarię Cloudflare w 2025 roku?
Problem z konfiguracją zakłócił działanie sieci w całej globalnej infrastrukturze.
Co spowodowało awarię Cloudflare w 2026 roku?
Problemy z routingiem i zachowaniem sieci miały wpływ na łączność niektórych użytkowników.
Jak przerwy w dostawie prądu wpływają na strony internetowe?
Mogą one powodować przestoje, spowolnienie działania i nieudane transakcje.
Jak firmy mogą sobie radzić z przestojami?
Poprzez wdrażanie strategii redundancji, monitorowania i przełączania awaryjnego.
Czy Cloudflare jest niezawodny pomimo przerw?
Tak, ale firmy muszą projektować systemy, które będą w stanie poradzić sobie z zakłóceniami.
Dzięki za opinie!

Praveen Soman Dyrektor generalny, Sigosoft
Przedsiębiorca technologiczny i strateg ds. produktów cyfrowych, pasjonat tworzenia skalowalnych produktów programistycznych i rozwiązywania rzeczywistych wyzwań biznesowych. Lubi zgłębiać sztuczną inteligencję, nowe technologie, startupy i idee kształtujące przyszłość technologii.
Połącz się na LinkedIn →Rozpocznij dyskusję
Masz pytania lub doświadczenia, którymi chcesz się podzielić? Nasz zespół czyta i odpowiada.